AI 会拖慢科学吗?
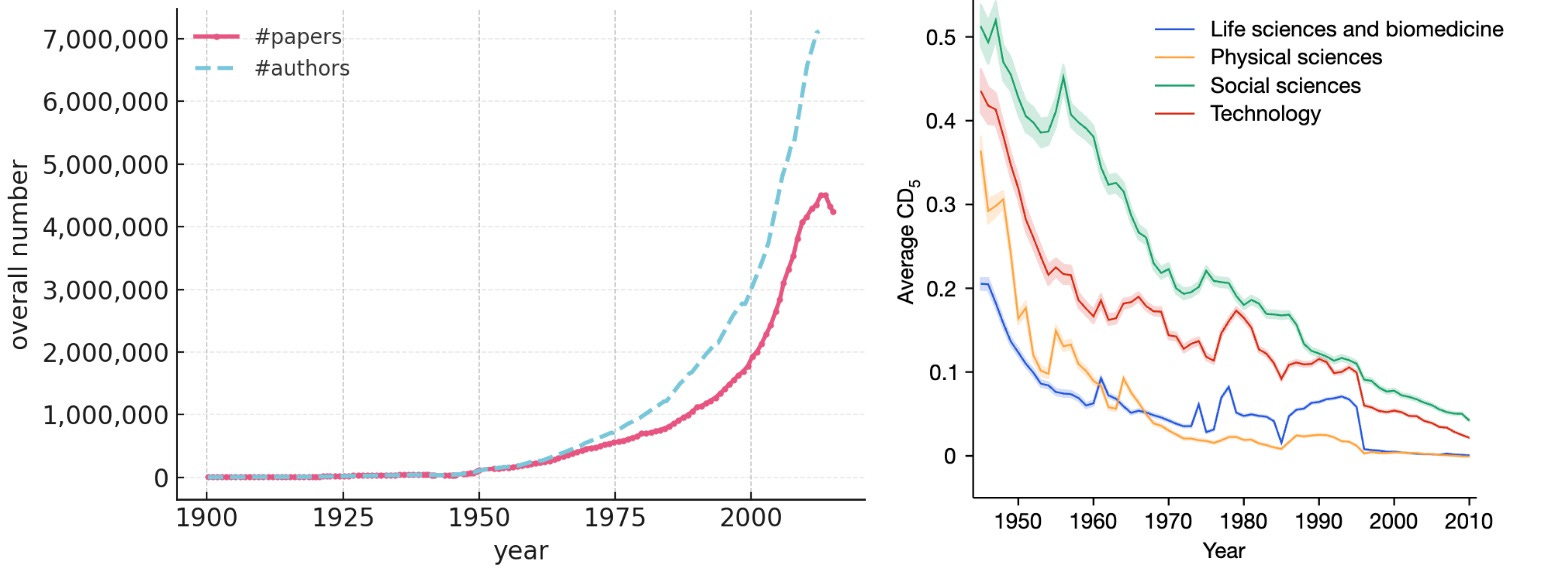
这是一篇关于”AI 对科学制度本身的影响”的长文。AI as Normal Technology 的两位作者 Sayash Kapoor 与 Arvind Narayanan 提出一个反直觉的判断:AI 领袖们预言 AI 将带来科学的巨大飞跃——治愈癌症、寿命翻倍、十年走完一个世纪的路;但个体科学家受益,不等于科学整体受益。对科学这个整体而言,AI 更可能是一剂”不健康的冲击”。
(以下为好读摘要与评论,非全文翻译)
摘要
论文数量指数增长,真正的进步却没有同步——这就是作者所说的”产出—进步悖论”。1900 到 2015 年间,科学论文发表量增长了 500 倍,科研经费和从业人数同样爆炸式增长;但元科学的多条证据都指向同一个方向:颠覆性工作在总产出中的占比越来越小,新词衡量的”认知广度”自 2000 年代初陷入停滞,诺奖级突破的分量并没有随投入增加。产出是产出,进步是进步,两者早已脱钩。
如果病根是”发得太多”,AI 只会让病情加重。发表或灭亡的激励下,生产容易衡量、进步难以衡量,学者理性地追逐可计数的产出、避开高风险的真突破;人的注意力有限,噪音越大,新想法越难穿透。AI 把科研流程自动化之后,只会让这套指标更容易被刷:个人也许更有创造力,集体的创造力却因同质化而下降。
科学还没准备好迎接软件,更别说 AI。大多数”AI for science”本质上是软件工程,但科研界的工程习惯远落后于工业界:缺少测试与版本管理,同行评审不看代码,连代码和数据都不愿共享。错误一旦进入文献可以潜伏多年——传统机器学习已在 30 个领域的 600 多篇论文中留下错误,生成式 AI 只会带来更多新型错误。
AI 可能让错误的理论活得更久。作者用地心说打比方:只要本轮加得足够多,地心说预测行星位置可以极准——但预测准不代表理解对。从地心说到日心说的飞跃,靠的不是更准的模型,而是更简单的理论。AI 建模擅长预测、不擅长解释;如果它让错误范式下的预测越来越准,领域反而会被锁死在旧范式里。
人类理解本身才是奖品。菲尔兹奖得主瑟斯顿的故事是全文最动人的论据:数学的目的不是判定命题真值,而是让人理解;解题和发论文只是仪式,真正的产出是理解。如果 AI 绕过理解直接给出答案,就像去健身房却用叉车举重——举得更重,但那不是去健身房的目的。
怎么办?作者把矛头指向制度而非个人:个人研究者当然该更谨慎地用 AI、补上软件工程课,但真正有权改变的是期刊、高校聘任委员会、资助方和政策制定者——奖励纠错与综合而不只奖励产出、投资元科学、把难以自动化的新理论与新范式纳入考核。他们也补了一句:别再给”AI 采用”更多激励了,它已经快得刹不住车,瓶颈从来不在这儿。
好读评论
这篇最有价值的地方,是把一个”感觉”变成了”机制”:我们都隐约觉得论文越来越多、突破越来越少,作者们却沿着激励链条一层层往下挖——注意力有限、噪音淹没新想法、生产指标绑架职业、AI 再把生产成本打到地板价。每一步都合乎个体理性,每一步都让集体更糟。这正是 Normal Technology 这一刊一以贯之的视角:别问技术能做什么,问它进入一个已有制度后,制度会变成什么样。
对中文读者来说,最扎心的是”发表或灭亡”这一节——这套激励在中国科研体系里只会更极致。而最值得偷走的,是作者对”理解”的辩护:在”AI 直接给答案”的时代,理解从副产品变成了稀缺品。瑟斯顿那个”健身房叉车”的比喻,值得贴在每一个用 AI 写论文的人的屏幕上。
值得一提的还有作者的诚实:他们承认自己也是 AI 的热情用户,写这篇时多次与自己的直觉作战。这种”我用,但我警惕”的姿态,比单纯的唱多或唱空都更可信。